二叉搜索樹,又稱二叉查找樹或二叉排序樹,是一種經典的數據結構。它或是一棵空樹,或是具有以下特性的二叉樹:
由於這種有序特性,二叉搜索樹在查找、插入、刪除操作上平均時間複雜度可達 O(log n),是實現動態集合與查找表的理想選擇。但在最壞情況(退化為鏈表)下會降至 O(n),因此工程實踐中常配合 AVL 樹、紅黑樹等平衡機制使用。
理解 BST 後,建議深入學習平衡二叉樹(AVL)、紅黑樹、伸展樹等自平衡變體,以及 B+ 樹在磁盤存儲場景下的應用,這將顯著提升對高性能數據結構的掌控力。
基於 `Graphics` 繪製雙數據序列折線圖,含標題、圖
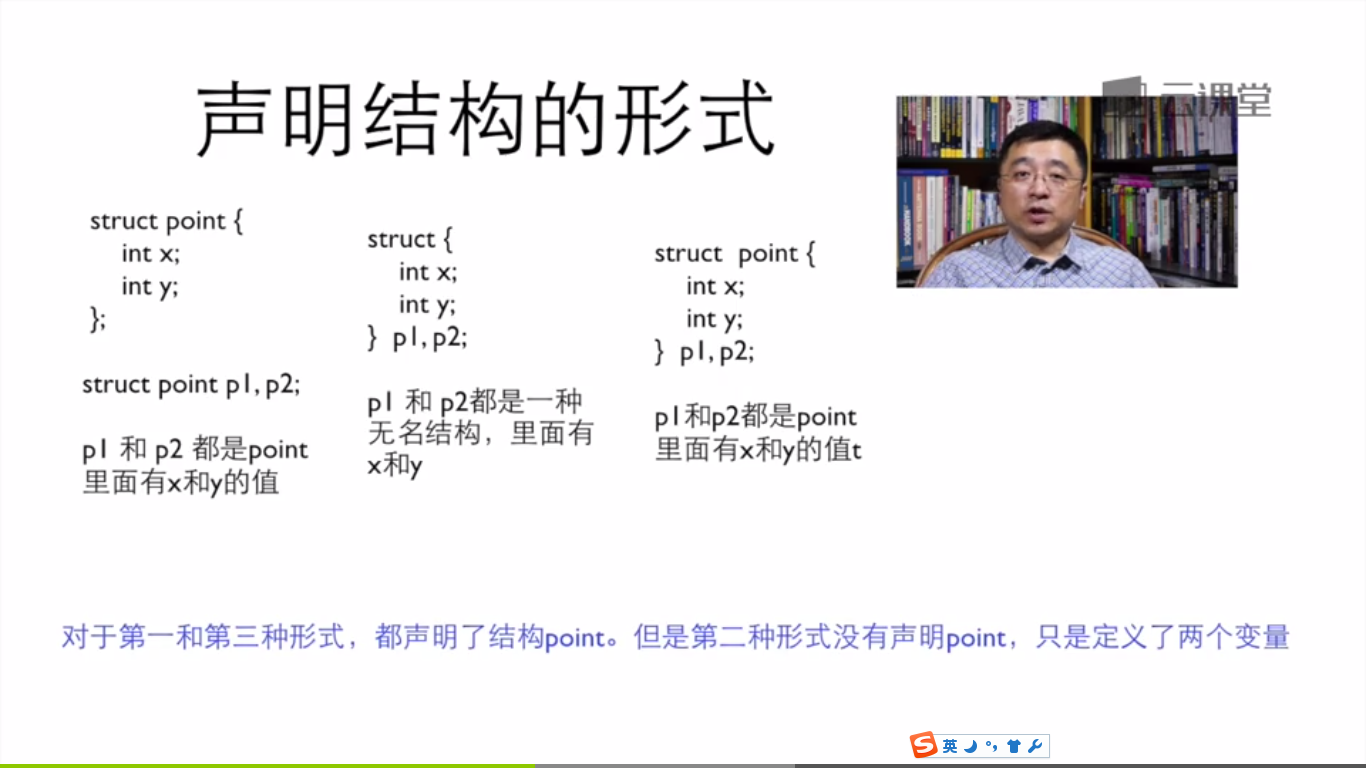
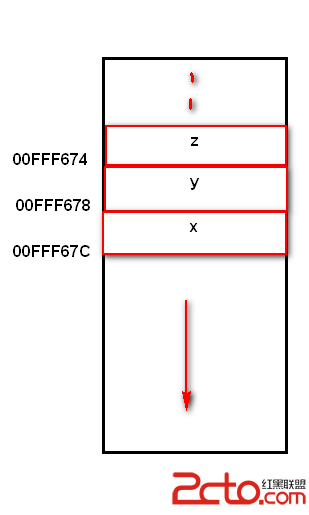
C語言學習筆記:枚舉與結構體完整指南 枚舉與結構體是 C 語
可變參函數:C 語言「多態」的底層基石 printf、sca
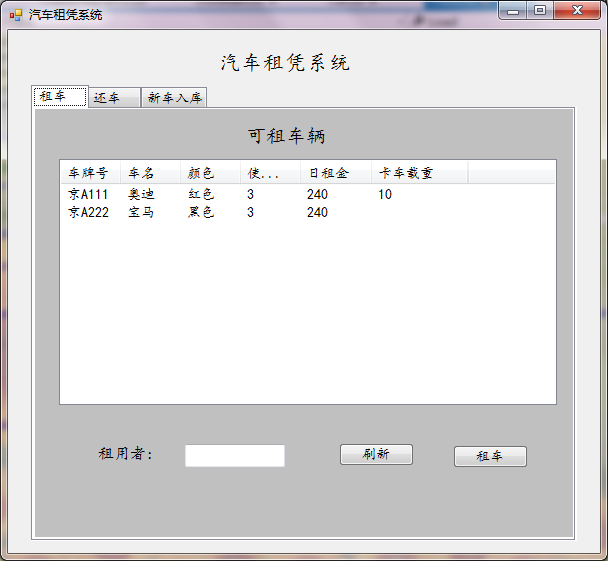
專案背景與設計目標 本專案為一個 Windows Forms