重讀《C專家編程》總能帶來新收穫,這正是「溫故而知新」的樂趣。最近研讀程序內存佈局與數組指針差異時,發現自己對C字符串的理解原本還存在模糊地帶,技術進步果然需要點滴積累。
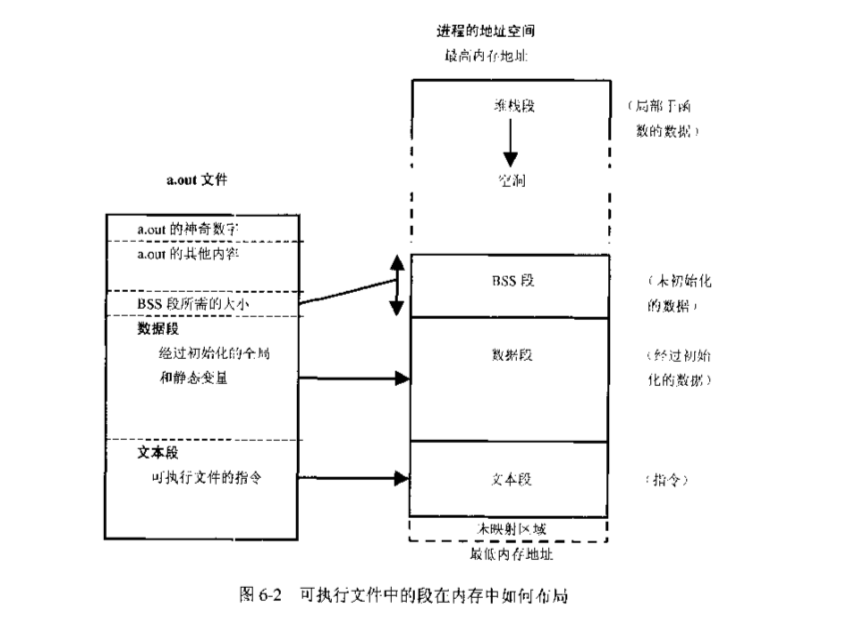
可執行文件在內存中主要分為以下段:
#include <stdio.h>
#include <stdlib.h>
#include <string.h>

char* p = "we are in text segment";      // 指針在數據段,字符串在文本段
char globalArr[] = "ds";                  // 數組在數據段
int globalInt = 6;                        // 數據段
int globalIntBSS;                         // BSS段
double globalDoubleBSS;                   // BSS段
char globalArrBSS[10];                    // BSS段

int main(void) {
    char arr[] = "we are in stack!";      // 棧區

    puts("\n=== 棧區地址 ===");
    printf("%p\n", arr);
    printf("%p\n", &arr[1]);
    printf("%p\n", &arr[2]);

    puts("\n=== BSS段地址 ===");
    printf("%p\n", &globalIntBSS);
    printf("%p\n", &globalDoubleBSS);
    strcpy(globalArrBSS, "lalala");
    printf("%s\n", globalArrBSS);
    printf("%zu\n", sizeof(globalArrBSS));
    printf("%p\n", globalArrBSS);
    printf("%p\n", &globalArrBSS[1]);

    puts("\n=== 數據段地址 ===");
    printf("%p\n", &p);           // 指針變量本身的地址
    printf("%p\n", globalArr);    // 數組首地址
    printf("%p\n", &globalArr[1]);
    printf("%p\n", &globalArr[2]);
    printf("%p\n", &globalInt);

    puts("\n=== 文本段地址 ===");
    printf("%p\n", p);            // 字符串常量地址
    printf("%p\n", &p[1]);

    return 0;
}
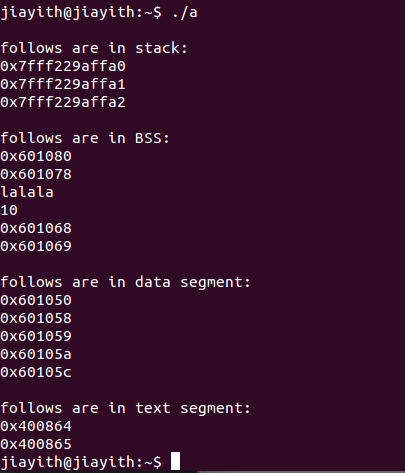
從輸出可見,各段地址差異明顯,驗證了內存佈局理論。
char arr[] = "we are in stack!"; 定義的字符數組存放在棧上。arr 標記了字符串首地址,因為是棧上變量,可讀可寫,修改 arr[1] = 'd'; 完全合法。
BSS段在目標文件中僅記錄未初始化變量的大小,不佔用文件空間。程序運行時由加載器分配並清零。
double globalDoubleBSS; 和 char globalArrBSS[10]; 均未初始化,故屬於BSS段。運行時用 strcpy() 賦值後可正常讀寫。
這裡有個關鍵區別:
char* p = "..."; —— 指針 p 在數據段(已初始化),但它指向的字符串常量在文本段(只讀)char globalArr[] = "ds"; —— 數組本身在數據段,內容可修改因此 globalArr[1] = 'a'; 合法,但 p[1] = 'a'; 會導致段錯誤。
char* p = "we are in text segment"; 中的字符串字面量存放在文本段,屬於只讀內存。嘗試修改會觸發 Segmentation Fault:
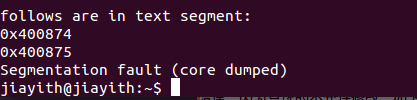
核心結論:char* p 與 char p[] 的本質區別在於——前者是指向只讀常量的指針,後者是可修改的字符數組。這正是《C專家編程》反覆強調的「數組與指針並不相同」的核心觀點之一。