本文通過實測數據深入剖析兩大優化方向:內存數據對齊對訪問速度的影響,以及循環展開提升指令級並行的技巧。
CPU 訪問內存有最小訪問粒度(MAG,典型值 8 字節)。當結構體大小與 MAG 為整數倍關係時,CPU 可按比例時間訪問;否則需多次讀取並拼裝,導致性能下降。
// 1字節對齊(打包)
#pragma pack(1)
struct NotAlignedStruct { char a,b,c; uint32_t d; }; // sizeof=7

// 默認對齊
struct AlignedStruct { char a,b,c; uint32_t d; }; // sizeof=8
遍歷 10 萬元素數組 10 萬次:
NotAlignedStruct:12,764,585 μsAlignedStruct:10,501,603 μs示例:sizeof(FirstStruct)=3、SecondStruct=24、ThirdStruct=16
針對 100 萬浮點數求和,對比三種實現:
for (i=0; i<len; i++) value += array[i];
耗時:1,221,869 μs
for (i=0; i<num; i+=4) {
    value += array[i];
    value += array[i+1];
    value += array[i+2];
    value += array[i+3];
}
耗時:1,221,701 μs(提升微乎其微)
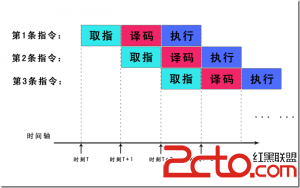
原因:浮點加法延遲遠大於分支預測開銷,且存在嚴格順序依賴,無法利用流水線。
float v1=1.0f, v2=1.0f;
for (i=0; i<num; i+=4) {
    v1 = array[i] + array[i+1];      // 獨立鏈路 1
    v2 = array[i+2] + array[i+3];    // 獨立鏈路 2
    value += v1 + v2;                // 合併結果
}
耗時:643,581 μs (性能近乎翻倍)
原理:打破數據依賴鏈,使 CPU 超標量流水線可並行執行兩條加法指令。
#pragma pack(1) 節省空間