指針與內存地址是C語言的核心難點,也是區分初級與資深開發者的關鍵分水嶺。本文通過圖解與實戰代碼,深度剖析數組名、指針、取地址運算符的本質區別,並徹底釐清sizeof與strlen的根本差異。
經典面試題:數組地址表達式含義
假設int a[4],首元素地址為0x8000(32位系統,int佔4字節),分析以下表達式:
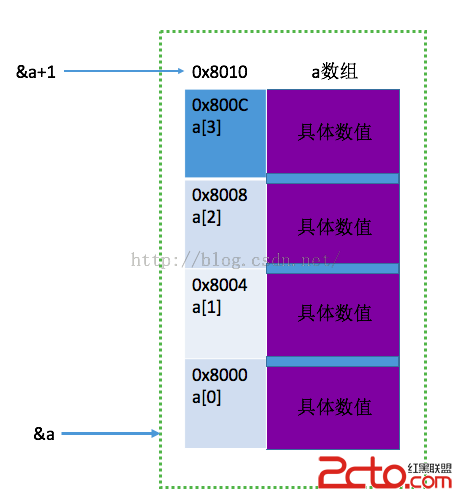
| 表達式 | 值 | 含義 | 類型 |
|---|---|---|---|
| &a[0] | 0x8000 | 首元素地址 | int* |
| a | 0x8000 | 數組名(轉換為首元素指針) | int* |
| &a | 0x8000 | 整個數組地址 | int(*)[4] |
| a+1 | 0x8004 | 第二個元素地址 | int* |
| &(a+1) | 錯誤 | 非法:a+1是右值不能取址 | - |
| &a+1 | 0x8010 | 數組結束後地址(跨過整個數組) | int(*)[4] |
核心結論:
a和&a[0]值相同但語義不同:前者是數組名(指針常量),後者是首元素地址&a類型是int(*)[4](指向包含4個int的數組指針),&a+1跨越整個數組大小(16字節)a+1按sizeof(int)步進,&a+1按sizeof(a)步進 只讀數據區
char str2[] = "good idea"; // 字符數組 -> 棧區(內容從只讀區拷貝)
printf("%p\n", &a); // 0x100001028 (較小地址)
printf("%p\n", &b); // 0x10000102c (緊隨a之後)
printf("%p\n", &c); // 0x7fff5fbff744 (棧區高地址)
printf("%p\n", &d); // 0x7fff5fbff740 (棧區,比c低)
printf("%p\n", str); // 0x100000f78 (只讀區,地址較小)
printf("%p\n", &str); // 0x7fff5fbff738 (棆區指針變量)
printf("%p\n", *(&str)); // 0x100000f78 (指針指向的內容)
printf("%p\n", str2); // 0x7fff5fbff75e (棧區數組)
printf("%p\n", &str2); // 0x7fff5fbff75e (數組名=首元素地址)
}
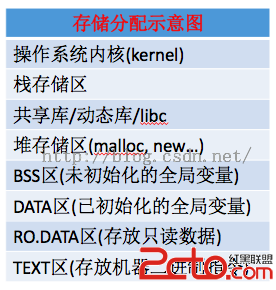
地址分佈規律:
核心差異:
| 特性 | sizeof | strlen |
|---|---|---|
| 性質 | 編譯時期運算符 | 運行時庫函數 |
| 計算對象 | 類型/變量佔用內存字節數 | 字符串實際長度(遇\0停止) |
| 參數 | 類型名或表達式 | 字符指針(char*) |
| 包含\0 | 是(若屬於數組一部分) | 否 |
經典案例分析:
數組作函數參數退化為指針:
四、 字符數組初始化陷阱與最佳實踐
危險代碼模式:
三種可能後果:
- 後續內存恰好為\0 → 正常輸出
- 後續內存非\0 → 輸出hello+亂碼直到遇到\0
- 訪問非法內存 → 程序崩潰(Segfault)
安全初始化模式:
五、 實戰調試技巧
徹底理解內存地址運算與
sizeof/strlen本質,是寫出高質量C代碼的基石。建議在調試時多用%p打印地址,結合sizeof驗證數組大小,養成初始化字符數組時預留\0空間的習慣。