Jemalloc 是由 Jason Evans 為 FreeBSD 開發的新一代記憶體分配器(2005 年首發),旨在取代傳統的 phkmalloc。Google 在 Android 5.0 將 Bionic 的預設分配器從 Dlmalloc 替換為 Jemalloc,核心看重其多核多執行緒下的極致分配效能。相較於經典 Dlmalloc,Jemalloc 在基本架構與實作策略上有根本差異:放棄傳統 boundary tag、採用 mmap 優先於 sbrk、引入 Arena/Chunk/Run/Region 多層級結構,犧牲單次分配速度換取大規模並發下的整體吞吐量與記憶體碎片控制。
Jemalloc 將記憶體由高至低劃分為五層:
此外尚有 Thread Cache (tcache)、Extent Node(Huge 分配追蹤)、Base Allocator(內部元資料分配)等輔助結構。
動機:傳統分配器單一 Global Lock 在多核下嚴重爭用;且不同執行緒分配的記憶體若落在同一 Cache Line(通常 64 Bytes),會導致 False Sharing 引發 Cache 失效風暴。
機制:Jemalloc 建立多個 Arena(預設 4 × CPU 核心數),執行緒透過 choose_arena() 綁定特定 Arena(優先選綁定數為 0 的 Arena,其次新建,最後選最閒置)。各 Arena 內部持有獨立鎖 arena_t.lock,僅在 Chunk/Run 分配、執行緒綁定時持有,實現無鎖快速路徑。
struct arena_s {
    unsigned ind;              // arenas 陣列索引
    unsigned nthreads;         // 綁定執行緒數
    malloc_mutex_t lock;       // Arena 級別鎖
    arena_bin_t bins[NBINS];   // Bin 陣列
    arena_avail_tree_t runs_avail; // 可用 Run 紅黑樹
    arena_chunk_t *spare;      // 最近釋放的 Chunk 快取
    // ... 統計、Prof、DSS 策略等欄位
};Chunk 預設 4 MB(LG_CHUNK_DEFAULT = 22),強制 4 MB 對齊。得益於對齊特性,任意記憶體位址 ptr 只需 CHUNK_ADDR2BASE(ptr)(位元遮罩下對齊)即可 O(1) 找到所屬 Chunk Header,無額外查表開銷。Chunk Header 包含:
arena_chunk_map_t map[]:動態陣列,每個 Page 一項,記錄 Page 狀態(Unallocated/Small/Large)、Run 所屬 Bin Index、Dirty/Zeroed/Allocated 旗標,位元壓縮儲存;dirty_link:掛載到 Arena 的 chunks_dirty 紅黑樹節點;ndirty, nruns_avail, nruns_adjac:統計資訊,供 Purge 決策使用。Run 內部切分為等大 Region,Region 大小遵循 Size Class 體系(size_classes.h 自動生成),採類二分伙伴演算法:
LG_TINY_MIN=3);關鍵映射函數 small_size2bin() 提供 O(1) Size→Bin Index 轉換:LOOKUP_MAXCLASS 以下查表(small_size2bin_tab),以上計算(Group Number + Offset)。反向 bin2size 則預計算陣列直接查表。
每個 Bin 對應一個 Small Size Class,內含:
runcur:當前分配用 Run(通常位址最低的 Non-full Run);runs 紅黑樹:掛載該 Size Class 所有 Non-full Run;lock:保護 runcur,粒度細於 Arena Lock。Bin 靜態資訊(Region Size, Run Size, Bitmap Offset, Region Count 等)集中在全域 arena_bin_info[],避免重複儲存。
Run 內部用 Bitmap 追蹤 Region 使用狀態(0=Free, 1=Used)。為避免線性掃描,Jemalloc 引入多層級 Bitmap:Level 0 每 bit 對應一 Region,Level 1 每 bit 對應 Level 0 一 Byte(32 Regions),以此類推。分配時從最高 Level 遞迴 ffs 定位第一個 0,複雜度 O(log Regions),大幅優於線性 O(Regions)。
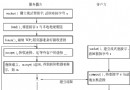
每個執行緒擁有 tcache_t,內含 tcache_bin_t 陣列,每 Bin 以 avail 堆疊快取 Region 指標。分配優先 tcache_alloc_easy 直接 Pop(O(1) 無鎖);快取耗盡時 arena_tcache_fill_small 向 Arena Bin 批次補貨(預設填滿 1/2^lg_fill_div)。釋放時 Push 回 tcache,滿則觸發 tcache_bin_flush_small 批次歸還 Arena。周期性 GC(ev_cnt 計數器)依 low_water 釋放 3/4 閒置 Region,動態調整填充比例,平衡記憶體佔用與分配延遲。
Huge 分配(> Chunk)直接 mmap,不經 Arena/Run。元資料用 extent_node_t 追蹤,掛載於雙紅黑樹(huge:AD 樹按位址、SZAD 樹按 Size+位址),支援快速查找與合併回收。
Arena、tcache、Extent Node 等內部結構本身需要記憶體,Base 從 Arena 空閒 Chunk 切分,採 base_next_addr 指標快速推進分配(Cache Line 對齊避免 False Sharing),耗盡時以 Chunk 為單位擴充。Extent Node 釋放時優先回收到 base_nodes 鏈表(復用 RB Tree 左子節點指標作 Link),避免遞迴分配死結。
small_size2bin(size) → Bin Index;runcur 有無 Free Region → arena_run_reg_alloc 直接分配(Bitmap 掃描 + 位址計算);runcur 滿或不存在 → arena_bin_malloc_hard:runs 樹取 Run → 填充 runcur;runs_avail 樹切分 Run(arena_run_split_small);arena_chunk_alloc 申請新 Chunk → 切分 Run;runcur(雙重檢查模式),決定使用新 Run 或歸還舊 Run。若執行緒綁定 tcache 且 Size ≤ tcache_maxclass,優先走 tcache:tcache_alloc_easy Pop → 失敗則 tcache_alloc_small_hard 觸發 arena_tcache_fill_small 批次補貨 → 再 Pop。
Size 對齊 Page → 直接從 Arena runs_avail 樹 First-Best-Fit 切分(arena_run_split_large),無 Bin 參與。tcache 同樣有 Large Bin 但不主動 Refill,僅被動收集釋放的 Large Region。
huge_palloc → CHUNK_CEILING 對齊 → arena_chunk_alloc_huge (mmap) → 建立 extent_node_t 掛載 huge 樹。
chunk_alloc_core 邏輯:
1. Recycle:優先從 4 棵全域 Chunk 樹(Mmap/DSS 各 AD+SZAD)搜尋可重用 Chunk(chunk_recycle),切分 Lead/Trail 多餘部分重新插入樹;
2. Mmap:嘗試 mmap,位址滿足 Alignment 直接返回,否則 munmap 重試 mmap_slow(超量分配 + Trim);
3. DSS (sbrk):將 dss_max 對齊 Chunk/Alignment 邊界後 sbrk,失敗則標記耗盡。
預設策略 dss_prec_secondary:Mmap → Recycle → DSS,追求靈活性而非單純速度。
idalloct 依 CHUNK_ADDR2BASE(ptr) == ptr 判斷 Huge(直接 huge_dalloc),否則進入 arena_dalloc。透過 Page Mapbits 區分 Small/Large,優先嘗試歸還 tcache(tcache_dalloc_small/large),tcache 滿或 GC 觸發則批次 Flush 回 Arena。
arena_run_reg_dalloc 清 Bitmap 標記 Free;arena_dissociate_bin_run 移出 Bin 樹 → arena_dalloc_bin_run 進入 Run 釋放流程;arena_run_dalloc:arena_run_coalesce 嘗試與前後 Unallocated Page 合併(需 Dirty Flag 一致);runs_avail 樹;arena_chunk_dalloc 釋放整個 Chunk;nactive / 8(opt_lg_dirty_mult=3)觸發 arena_purge。Purge 不 munmap,而是 madvise(MADV_DONTNEED) 釋放物理頁面對應,虛擬位址保留供未來 Recycle。流程:
nruns_avail - nruns_adjac / nruns_avail)排序 Dirty Chunk 樹,優先清理高碎片 Chunk;arena_chunk_stash_dirty 將待 Purge 的 Unallocated Dirty Page 臨時轉為 Large Run(避開 Arena Lock 下的線性掃描);pages_purge (madvise);arena_chunk_unstash_purged 將 Purge 後 Page 重新 arena_run_dalloc 歸入 runs_avail(cleaned=true 標記 Clean)。Android 啟用 ANDROID_ALWAYS_PURGE 強制每次釋放皆 Purge,適應記憶體緊張環境。
arena_chunk_dalloc:移出 runs_avail → 若 spare 非空,舊 Spare 真正 chunk_dalloc_internal(歸入全域樹或 munmap),新 Chunk 成為 Spare;否則直接存為 Spare。利用局部性原理減少系統呼叫。
Large:arena_run_dalloc(同 Small Run 釋放)。
Huge:從 huge AD 樹移除 Node → arena_chunk_dalloc_huge → chunk_dalloc(Recycle 或 Munmap)→ base_node_dalloc 回收 Extent Node。
| 維度 | Jemalloc | Dlmalloc |
|---|---|---|
| 多執行緒縮放 | Arena 隔離 + tcache 無鎖,核心數越多越快 | 單一 Global Lock,嚴重爭用 |
| 記憶體回收 | Mmap/Madvise 組合,靈活 Purge,虛擬位址復用 | Sbrk/Munmap,條件嚴格,易產生洞 |
| Bookkeeping | Chunk Map + Bitmap,元資料與使用者記憶體分離 | Boundary Tag,元資料夾雜在 Chunk 內 |
| Size Class | Binary Buddy 風格,四層細分,跨架構自動生成 | 固定 8B 間距至 256B,再接 Power-of-2 |
| 安全性 | 元資料分離,抗 Overflow/Use-after-free | Boundary Tag 易被覆寫,安全性弱 |
| 單執行緒小塊速度 | Bitmap 多層掃描,略慢於 O(1) 雙向鏈表 | Free List O(1),理論更快 |
# 靜態庫編譯並啟用除錯
./configure --enable-debug --with-jemalloc-prefix=my_
make && make install
# 應用程式連結
gcc main.c /usr/local/lib/libjemalloc.a -std=c99 -O0 -g3 -pthread -o jhello關鍵選項:--disable-tcache 觀察 Arena 路徑、--disable-prof 關閉 Profiling、--enable-debug 開啟 Assert 與關閉優化。
Jemalloc 以 Arena 隔離鎖競爭、tcache 消除執行緒間干擾、Chunk/Run/Region 多層級結構實現精細記憶體管理、Mmap/Madvise 組合達成彈性回收,構建出在現代多核硬體上極具競爭力的分配器。其設計哲學——以空間換時間、以複雜度換平行度、以元資料分離換安全性——為高效能系統軟體開發提供了經典範本。深入理解其原理,不僅有助於效能調優,更能啟發自訂分配器、記憶體池、物件池等基礎設施的設計思路。