搜尋引擎的核心資料來源來自於網路爬蟲。早期 Yahoo 採人工分類,隨著網頁數量爆炸性增長,Google 以自動化爬蟲 + 智能演算法徹底改變遊戲規則。爬蟲的任務簡單而艱鉅:從種子網址出發,不斷下載、解析、提取新連結,構建龐大的網頁資料庫。本文將帶你用 C# 2.0 從零實作一個具備多線程下載、檔案級佇列持久化、鍵樹去重優化的網路爬蟲原型。
index.txt。<a href=...> 中的連結。記憶體無法承載千萬級 URL,必須落地。FileIO 封裝 FileStream + StreamReader/Writer,關鍵在於 FileShare.ReadWrite 允許同時開啟讀寫流,實現「生產者-消費者」模式:
// 寫入追加
fsw = new FileStream(file, FileMode.Append, FileAccess.Write, FileShare.ReadWrite);
sw = new StreamWriter(fsw);
sw.WriteLine(url); sw.Flush();

// 讀取
fsr = new FileStream(file, FileMode.OpenOrCreate, FileAccess.Read, FileShare.ReadWrite);
sr = new StreamReader(fsr);
string line = sr.ReadLine();
繼承 MyThread 即可自動擁有線程能力,覆寫 run() 撰寫業務邏輯,比直接操作 Thread 更具物件導向風格:
class MyThread {
    private Thread thread;
    public MyThread() { thread = new Thread(run); }
    public virtual void run() { }
    public void start() { thread.Start(); }
    public void sleep(int ms) { Thread.Sleep(ms); }
}
// 使用範例
class Downloader : MyThread {
    public override void run() { /* 下載邏輯 */ }
}
每線程對應一個資料目錄,檔案數達上限(如 5000)自動建立新目錄。核心迴圈:從佇列批次取出 20 條 URL → 下載解析 → 寫入 index.txt → 觸發 findUrl 事件將新連結送回佇列。若佇列空則呼叫 Common.threadWait 通知系統並休眠 5 秒。
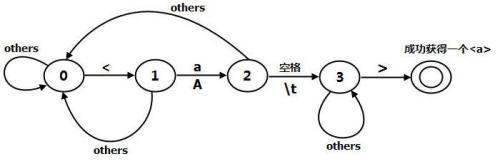
採用 5 狀態有限狀態機(FSM)掃描字元流,精準識別 <a ...> 標籤,再以正則 href\s*=\s*('[^']*'|"[^"]*"|\S+) 擷取 href 值,最後處理相對/絕對路徑轉換與過濾規則(processPattern)。
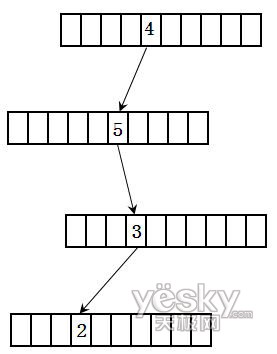
將 URL 經 GetHashCode() 轉為 32 位整數,以十進位每一位為分支建立鍵樹。查找複雜度僅與數字位數有關(O(10)),與資料總量無關,極大降低記憶體佔用並提升速度。UrlFilter 進一步正規化 URL(去除預設埠號、統一路徑斜線)確保 https://a.com 與 https://a.com/ 視為同一鍵值。
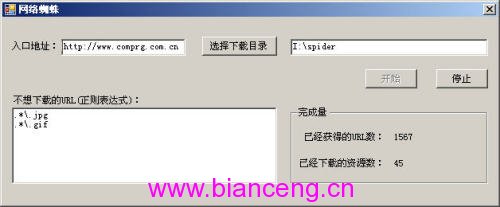
主視窗透過 Timer 每 2 秒讀取 Common 靜態類別的計數器,即時顯示已獲取 URL 數、已下載頁面數。文末指出單機極限,建議將鍵樹與佇列移至共享儲存或引入分散式協調服務(如 ZooKeeper),實現多機協同爬取,獲得質的速度飛躍。