學習編譯原理並為 DocWizard 準備詞法分析技術時,筆者設計了一種無需修改代碼即可通過更換規則表分析不同 DFA 的詞法分析內核。
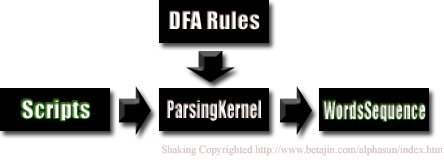
圖一:腳本經過解析內核,依據 DFA 規則生成單詞序列
核心組件:
每條規則 CStateChangeRule 包含三項:
int nCurStateint nNextStateCHAR_RANGE route[ROUTE_BUF_LEN]void CAjaxParserDlg::OnParse() {
char* pszLine = " void CAjaxParserDlg::OnParse() +12.3 12.3 -12.3 -.12 +.12 .12 +12. -12. 12. .023 ";
int i=0, nLen, nState=0, nNext=-1, nStart;
nLen = strlen(pszLine);
while(i < nLen) {
if(nState == 0) nStart = i; // 新單詞起始位置
nNext = Route(nState, *(pszLine+i)); // 查表得下一狀態
Accept(nState, nNext, pszLine+nStart, i-nStart); // 接收單詞
if(!(nState!=0 && nNext==0)) i++; // 非「接受狀態轉回0」時推進
nState = nNext;
}
Accept(nState, 0, pszLine+nStart, i-nStart); // 處理最後一個單詞
}int CAjaxParserDlg::Route(int nCurState, BYTE c) {
int nSize = m_ruleArr.GetSize();
for(int i=0; i註:示例採用線性搜索,實際應用可改用哈希或跳表提速。
void CAjaxParserDlg::Accept(int nCurrent, int nNext, LPCTSTR pszLine, int nLen) {
    if(nNext == 0 && nCurrent != 0) { // 當前是終止態且下一狀態回0
        // 輸出單詞:狀態號 + 文本
        // 實際應用中存入單詞數組
    }
}// 標識符規則:狀態0 通過 _ 或 字母 進入狀態1
CStateChangeRule rule;
rule.nCurState = 0; rule.nNextState = 1;
rule.route[0].byStart = '_'; rule.route[0].byEnd = '_';
rule.route[1].byStart = 'A'; rule.route[1].byEnd = 'Z';
rule.route[2].byStart = 'a'; rule.route[2].byEnd = 'z';
m_ruleArr.Add(rule); rule.Clear();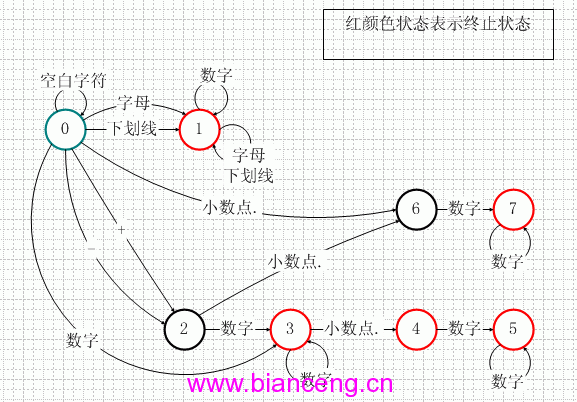
圖二:示例 DFA 狀態轉換圖
m_stateArr 記錄各狀態屬性(如是否為終止態),下標為狀態編號。
詞法分析相對簡單,但語法分析理論尚不完全形式化,構造困難。筆者早期做 DocWizard 未用教科書方法,結果不理想。下一步計劃深入學習 lex/yacc,利用成熟工具構建分析器。