分布式系統的學習往往始於 Google 的三篇經典論文:GFS、MapReduce、BigTable。這些論文勾勒出分布式存儲與計算的藍圖,但缺乏具體實現細節。開源項目 Hadoop 填補了這一空白,它以 Java 實現了 HDFS(分布式文件系統)和 MapReduce 計算框架,並衍生出 HBase、ZooKeeper 等生態組件。結合論文理論與 Hadoop 源碼,能更透徹地理解分布式文件系統的設計精髓。
GFS 與 HDFS 雖架構相似,但術語差異較大。為避免混淆,本文統一採用中文通用術語,並對照兩者對應名稱:
| 統一術語 | HDFS 術語 | GFS 術語 | 釋義 |
|---|---|---|---|
| 主控服務器 | NameNode | Master | 文件系統大腦,管理目錄樹與數據塊映射 |
| 數據服務器 | DataNode | Chunk Server | 存儲實際數據塊的工作節點 |
| 數據塊 | Block | Chunk | 文件切分的基本存儲單元,默認 64MB |
| 數據包 | Packet | — | 客戶端寫入時的緩衝單位 |
| 傳輸塊 | Chunk | — | 數據包內含校驗碼的最小傳輸單元(512B) |
| 備份主控服務器 | SecondaryNameNode | — | 定期合併日志與鏡像,協助故障恢復 |
註:基於 Hadoop 0.19.0 版本分析。
分布式文件系統由三類服務器協作:
數據服務器磁盤佈局:每個數據塊對應一對文件(數據文件 + 元文件),組織在 current 目錄及最多 64 個子目錄(dir0-dir63)中,利用多級目錄控制單目錄文件數量,提升檢索速度。
內存數據結構:Block 代表數據塊,FSDataset 管理所有塊,包含 FSVolumeSet(多卷集合),每卷對應一個磁盤掛載點,支持多磁盤並行 I/O。
主控服務器元數據:持久化存儲目錄結構(FSDirectory)與文件分塊信息(INodeFile 中的 BlockInfo 陣列),數據塊位置信息僅駐留內存,由 DataNode 啟動時上報動態構建,避免持久化同步開銷。
Hadoop 自研 RPC 框架,定義接口、服務端實現、客戶端代理調用。通信模式為拉取式:RPC 服務端被動等待調用。關鍵協議包括:
ClientProtocol:客戶端 ↔ NameNode(元數據操作)DatanodeProtocol:DataNode ↔ NameNode(心跳、塊上報、命令下發)ClientDatanodeProtocol:客戶端 ↔ DataNode(數據讀寫,繞過 RPC 直連)InterDatanodeProtocol:DataNode 間流水線傳輸與恢復協作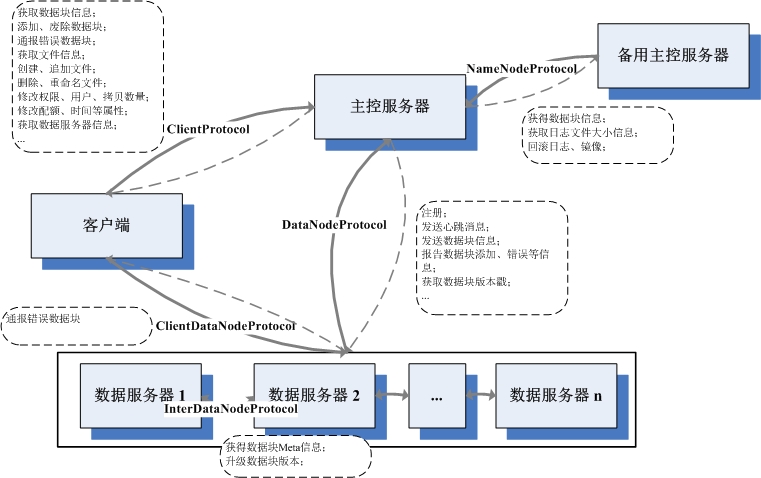
所有目錄操作僅涉及客戶端與 NameNode,流程:DFSClient → ClientProtocol(RPC) → NameNode → FSNamesystem → FSDirectory。關鍵步驟含權限校驗、租約管理、編輯日志記錄。NameNode 不主動推送指令給 DataNode,而是將待刪除塊放入隊列,待 DataNode 心跳時拉取執行,減少通信開銷。
採用「中介+直連」模式:客戶端向 NameNode 獲取塊位置列表(LocatedBlocks),再直接連接 DataNode 讀取。讀取流程:選擇最近可用副本 → 建立連接 → 流式傳輸數據包 → 塊讀完切換下一塊。當前實現簡單選取第一個存活節點,未考慮網絡拓撲感知。
HDFS 僅支持追加寫,簡化並發控制。寫入流程:
INodeFileUnderConstruction(鎖機制),簽發租約。dataQueue 發送,ackQueue 等待應答,ResponseProcessor 線程處理回包。流水線機制確保多副本同步寫入,任一節點失敗觸發租約恢復。
sendHeartbeat)上報存活與存儲狀態;塊報告(blockReport)周期性全量同步塊列表。NameNode 對比內存元數據,下發刪除/複製指令(DatanodeCommand)。FSEditLog)記錄所有元數據變更,定期生成鏡像(FSImage)。SecondaryNameNode 定期下載日志與鏡像合併生成新鏡像上傳回 NameNode。故障時啟動備用節點,以最新鏡像+日志重放恢復元數據。採用 CRC32 校驗:客戶端將數據包切分為 512B Chunk,計算校驗碼隨包發送。流水線末端 DataNode 驗證,失敗觸發 Lease Recovery:選取主數據節點,以最小塊長度為準截斷多餘數據,協議為 InterDatanodeProtocol,由主節點發起,降低 NameNode 負擔。
ReplicationTargetChooser 綜合備份數、客戶端位置、機架拓撲,優先滿足寫入性能與跨機架容災。Balancer 獨立進程運行,獲取各節點負載,發起塊遷移(OP_REPLACE_BLOCK),目標節點接收後通知 NameNode 刪除源副本。兩類垃圾:正常邏輯產生(文件刪除、塊遷移)由 NameNode 直接記入 recentInvalidateSets;異常產生(節點重啟發現過期副本)由 DataNode 上報塊列表時對比發現。心跳交互中 NameNode 下發刪除命令,DataNode 直接物理刪除(HDFS 不保留回收站機制)。
分布式文件系統的核心模式——單點元數據管理、數據塊冗余存儲、基於日志的故障恢復、租約機制、流水線寫入——在後續的分布式計算(MapReduce)與數據庫(HBase)中反復出現。理解 HDFS 不僅是掌握一個存儲系統,更是洞悉分布式系統設計通用原理的窗口。對上層應用而言,HDFS 可視為一個跨機器透明訪問的 POSIX-like 文件系統,屏蔽了分布式複雜性。