多重繼承(MI)常因名稱查找(Name Lookup)規則導致令人困惑的「二義性」編譯錯誤。本文透過兩個經典繼承圖,深入解析 C++ 編譯器如何在靜態型別基礎上進行名稱查找、多載解析與存取檢查,釐清為何相同呼叫在不同指標型別下行為截然不同。
圖 1:菱形繼承(共享基類 A)
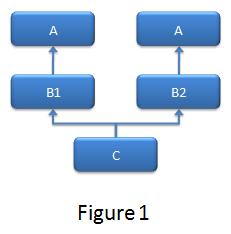
C* p = new C;
p->Method_of_A(); // 編譯通過,無二義性
圖 2:獨立雙基類(B1、B2 各自繼承 A)
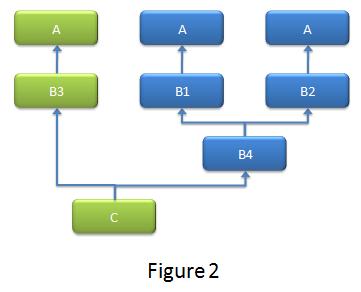
B4* p = new C;
p->Method_of_A(); // 編譯錯誤:ambiguous
關鍵點:全程基於靜態型別(指標/參考型別),與動態物件型別無關。
C* p = new C;
p->Method_of_A();C*,名稱查找僅在 C 類別內進行。Method_of_A(),候選清單僅有一個 → 直接繫結 C::Method_of_A,查找結束,完全不會搜尋到 A。B4* p = new C;
p->Method_of_A();B4*,B4 本身無 Method_of_A。B1、B2,各找到一個 A::Method_of_A(繼承而來)。adjustor thunk(指標調整樁碼)僅影響呼叫時的 this 指標調整,發生在名稱查找之後,非二義性成因。
using B1::Method_of_A; 或 using B2::Method_of_A; 明確指定路徑。Method_of_A() 統一入口(如圖 1)。static_cast<B1*>(p)->Method_of_A();「名稱查找只看靜態型別,不看動態物件;找到第一層有候選就停止,不再往上;候選多於一且無法多載解析即報二義性。」
理解此規則,即可在複雜 MI 體系中精準控制名稱可見性,避免誤判為編譯器缺陷。