GPU 並行計算的效能天花板很高,但也很容易寫出低效代碼。以下 10 大優化技巧源自實戰經驗,適用於 OpenCL、CUDA 等主流 GPGPU 平台,涵蓋指令級、記憶體級、線程級優化。
原理:已知迴圈次數時,手動展開可消除迴圈計數器更新與條件判斷指令。
// 展開前
for (int i = 0; i < 100; i++) sum += data[i];

// 展開後 (5x unroll)
for (int i = 0; i < 100; i += 5) {
    sum += data[i];
    sum += data[i+1];
    sum += data[i+2];
    sum += data[i+3];
    sum += data[i+4];
}
⚠️ 注意:過度展開會增加指令快取壓力、寄存器壓力,導致佔用率下降。建議展開因子 4-8x,並配合 #pragma unroll 讓編譯器自動決定。
問題:Subnormal numbers (接近零的極小浮點數) 在硬體處理時會觸發微碼路徑,效能下降 10-100x。
解決:編譯選項啟用 -cl-denorms-are-zero (OpenCL) 或 -ftz=true (CUDA),將非正規數視為零。
clBuildProgram(program, 0, NULL, "-cl-denorms-are-zero", NULL, NULL);
錯誤做法:每個 work-item 定義 private 變量存放常量
__kernel void bad_kernel(__global float* out, int N) {
    const float PI = 3.14159f;  // 每 thread 佔用寄存器
    // ...
}
正確做法:編譯選項傳遞巨集定義
clBuildProgram(program, 0, NULL, "-DPI=3.14159f", NULL, NULL);

// Kernel 中直接使用 PI,編譯器直接內嵌常數值,零寄存器開銷
存取延遲層級:Register (Private) > L1/Shared (Local) > L2 > Global
若變數無需跨 work-item 共享,優先使用 private memory (寄存器)。寄存器溢位時硬體自動溢出到 local/global memory (spilling)。
硬體架構:Local memory 分為 32 個 banks (NVIDIA) 或 16/32 banks (AMD/Intel),連續 32-bit 字交錯分布。
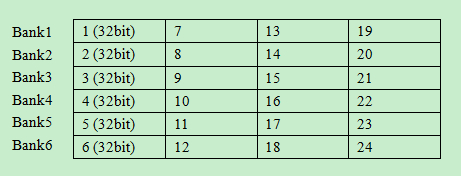
三種訪問模式:
| 模式 | 範例 | 效能 |
|---|---|---|
| 無衝突 (理想) | local_data[tid]、local_data[tid * 2] | 單週期、全並行 |
| Bank Conflict | local_data[tid * 16] (32 banks 時) | 序列化、效能下降 16-32x |
| 廣播 (特例) | 所有 thread 讀同一位址 local_data[0] | 單週期、硬體廣播機制 |
解決方案:陣列填充 (padding) 破壞交錯衝突
// 壞:16-way bank conflict
__local float shared[64];
float val = shared[tid * 16];

// 好:無衝突
__local float shared[64 + 16];  // padding 16 elements
float val = shared[tid * 17];   // stride 17 避開衝突
% 在 GPU 上極慢 (數十週期)。替代方案:
x % 64 → x & 63idx = (idx + 1) & (SIZE - 1) (SIZE 必須是 2 的冪)同一寄存器在不同時期用於不同用途,用巨集定義語義別名,節省寄存器:
__kernel void kernel(...) {
    float temp;

    #define PHASE1_VAR temp
    PHASE1_VAR = compute_phase1();
    // ... 使用 PHASE1_VAR ...

    #define PHASE2_VAR temp
    PHASE2_VAR = compute_phase2();
    // ... 使用 PHASE2_VAR ...
}
編譯器看到同一變數生命週期不重疊,會分配同一寄存器。
a * b + c 單指令完成,精度更高 (僅最終結果捨入)、延遲更低。
// 編譯器自動優化 (需啟用 -ffast-math 或 -cl-fast-relaxed-math)
float result = a * b + c;

// 手動使用內建函數 (保證使用 FMA)
float result = fma(a, b, c);  // 需定義 FP_FAST_FMAF
Kernel 檔案中輔助函數加 inline,消除函數呼叫開銷 (參數傳遞、堆疊操作)。
inline float3 rotate(float3 v, float angle) {
    float c = cos(angle), s = sin(angle);
    return (float3)(v.x * c - v.y * s, v.x * s + v.y * c, v.z);
}

__kernel void main_kernel(...) {
    float3 v = rotate(input, angle);  // 編譯器直接內展開
}
代價:程式碼膨脹可能增加指令快取壓力,適用於小型熱點函數。
GPU 以 Warp (32 threads, NVIDIA) 或 Wavefront (64 threads, AMD) 為單位執行。分支發散導致序列化執行。
優化策略:
// 壞:隨機分支
if (data[tid] > threshold) { ... } else { ... }

// 好:預計算掩碼
int mask = (data[tid] > threshold) ? 0xFFFFFFFF : 0;
result = (true_val & mask) | (false_val & ~mask);

// 更好:資料預排序,使同 warp 內 thread 走同一分支
| 優化項目 | 檢查點 | 工具驗證 |
|---|---|---|
| 循環展開 | 熱點迴圈是否展開 4-8x | NSight Compute / CodeXL |
| 非正規數 | 是否啟用 -cl-denorms-are-zero | 編譯日誌 |
| 常量傳遞 | 編譯選項 -D 定義 | PTX/ISA 檢查 |
| Private 變數 | 無共享變數用 private | 寄存器壓力報告 |
| Bank Conflict | Local memory 存取 stride | NSight Compute Shared Memory 分析 |
| 模運算 | 熱點路徑無 % 操作 | PTX 搜尋 UREM |
| 寄存器重用 | 生命週期不重疊變數合併 | 寄存器使用統計 |
| FMA 使用 | 關鍵數學運算用 fma() | PTX 檢查 FMA 指令 |
| 內聯函數 | 輔助函數加 inline | 程式碼大小、指令快取 |
| 分支發散 | Warp 內分支一致性 | NSight Compute Warp Divergence |