散列表是一種以常數平均時間複雜度實現插入、刪除和查找操作的數據結構。其核心思想是透過散列函數將鍵值映射到固定大小數組的索引位置,通常表大小取質數以減少衝突。當不同鍵值映射到同一索引時發生衝突,需採取相應解決策略。
優良的散列函數應使鍵值均勻分布。本文採用多項式滾動散列:對字符串每個字符計算 hashVal = 37 * hashVal + key[i],最後對表大小取模。此函數涉及所有字符,分布效果良好,並處理負值情況。
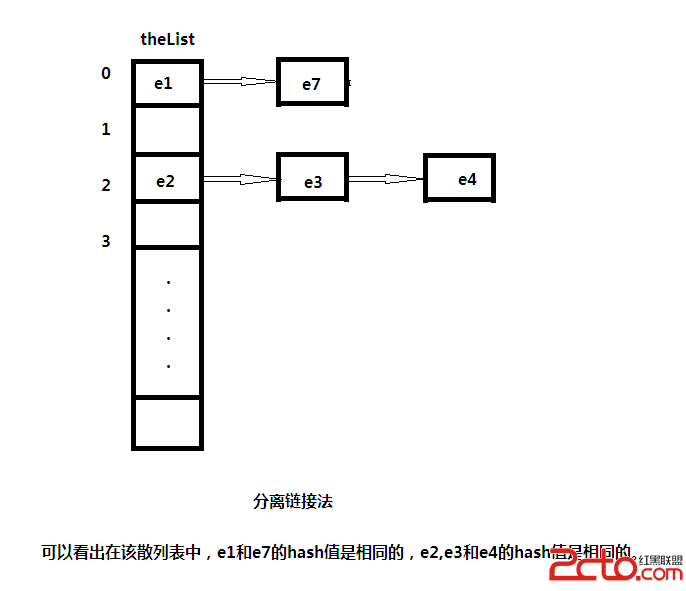
分離鏈接法將散列到同一索引的元素存儲在鏈表中,本實現使用 STL list(雙向鏈表)。散列表結構為 vector<list<HashedObj>>,每個桶位對應一個鏈表。
當負載因子過大時,將表大小擴展為原來的兩倍(取下一個質數),並重新插入所有元素:
template <typename HashedObj>
void HashTable<HashedObj>::rehash() {
    vector<list<HashedObj>> oldLists = theLists;
    theLists.resize(nextPrime(2 * theLists.size()));
    for (auto & list : theLists) list.clear();
    for (auto & list : oldLists)
        for (auto & item : list) insert(item);
}透過函數重載支援不同類型鍵值,最終調用通用 hash(key) 並對表大小取模:
template <typename HashedObj>
int HashTable<HashedObj>::myhash(const HashedObj & key) const {
    int hashVal = hash(key);
    hashVal %= theLists.size();
    if (hashVal < 0) hashVal += theLists.size();
    return hashVal;
}先檢查元素是否存在,不存在則插入鏈表尾部,並檢查是否需要再散列:
template <typename HashedObj>
bool HashTable<HashedObj>::insert(const HashedObj & x) {
    auto & whichList = theLists[myhash(x)];
    if (find(whichList.begin(), whichList.end(), x) != whichList.end())
        return false;
    whichList.push_back(x);
    if (++currentSize > theLists.size()) rehash();
    return true;
}刪除時定位對應鏈表並移除元素;查找返回元素或預構造對象:
template <typename HashedObj>
bool HashTable<HashedObj>::remove(const HashedObj & x) {
    auto & whichList = theLists[myhash(x)];
    auto it = find(whichList.begin(), whichList.end(), x);
    if (it == whichList.end()) return false;
    whichList.erase(it);
    --currentSize;
    return true;
}定義 Employee 類別並重載比較運算符,主程式測試插入、查找、刪除、清空等操作,輸出驗證正確性。完整代碼包含質數查找、構造/析構函數等細節,可直接編譯運行。