在計算機科學領域,排序被公認為算法研究中最基礎、也是最關鍵的問題之一。許多學者指出,對待解決的問題先進行排序,往往能簡化問題分析並啟發求解思路。本文將系統梳理主流排序算法,涵蓋比較排序與非比較排序兩大類別,並附帶 C++ 代碼實現與複雜度分析。
根據是否需要比較元素大小,排序算法分為比較排序與非比較排序。
比較排序通過元素間的大小比較確定相對順序。根據決策樹模型可證明:任意比較排序對 n 個元素排序的最壞情況時間下界為 Ω(n log n)。因此,堆排序與歸並排序達到 O(n log n) 最壞情況複雜度,屬於漸近最優比較排序。
常見比較排序包括:
原址排序(In-place)優勢在於不需額外大量空間,適合記憶體受限環境。快速排序雖最壞情況為 O(n²),但期望時間 O(n log n) 且隱含常數極小,是大數組排序的首選。
打破 Ω(n log n) 下界,利用數據特殊性質實現線性時間:
| 算法 | 最壞情況 | 平均/期望時間 |
|---|---|---|
| 插入排序 | O(n²) | O(n²) |
| 歸並排序 | O(n log n) | O(n log n) |
| 堆排序 | O(n log n) | — |
| 快速排序 | O(n²) | O(n log n) |
| 計數排序 | O(k+n) | O(k+n) |
| 基數排序 | O(d(n+k)) | O(d(n+k)) |
| 桶排序 | O(n²) | O(n) |
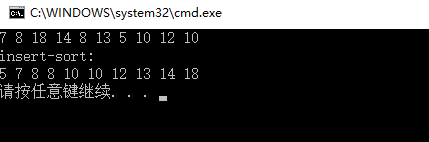
核心思想:將數組分為「已排序」與「未排序」兩部分,每次從未排序區取出元素,在已排序區從後向前比較並移動元素,找到插入位置。
特點:穩定、原址、代碼緊湊、適合小規模或近乎有序數據。
void insert_sort(vector<int>& A) {
    for (int i = 1; i < A.size(); ++i) {
        int key = A[i];
        int j = i - 1;
        while (j >= 0 && A[j] > key) {
            A[j + 1] = A[j];
            --j;
        }
        A[j + 1] = key;
    }
}
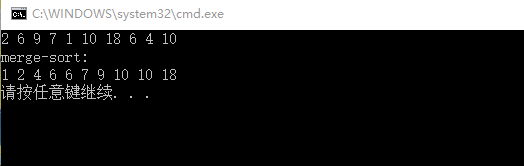
核心思想:分治法。遞歸將數組二分至單元素,再通過 merge 操作將兩個有序子數組合併。
特點:穩定、時間複雜度固定 O(n log n)、需 O(n) 輔助空間。
void merge(vector<int>& nums, int left, int mid, int right) {
    vector<int> L(nums.begin() + left, nums.begin() + mid + 1);
    vector<int> R(nums.begin() + mid + 1, nums.begin() + right + 1);
    L.push_back(INT_MAX);
    R.push_back(INT_MAX);
    int i = 0, j = 0;
    for (int k = left; k <= right; ++k) {
        if (L[i] <= R[j]) nums[k] = L[i++];
        else nums[k] = R[j++];
    }
}

void merge_sort(vector<int>& nums, int left, int right) {
    if (left < right) {
        int mid = (left + right) / 2;
        merge_sort(nums, left, mid);
        merge_sort(nums, mid + 1, right);
        merge(nums, left, mid, right);
    }
}
堆排序基於二叉堆數據結構,分為最大堆(父節點 ≥ 子節點)與最小堆(父節點 ≤ 子節點)。
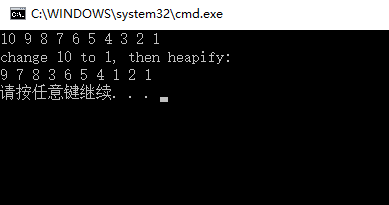
max_heapify「逐層下沉」策略:假設左右子樹已是最大堆,若根節點小於某子節點,則交換並遞歸向下調整,時間 O(log n)。
void max_heapify(vector<int>& a, int i, int heap_size) {
    int largest = i;
    int left = 2 * i + 1;
    int right = 2 * i + 2;
    if (left < heap_size && a[left] > a[largest]) largest = left;
    if (right < heap_size && a[right] > a[largest]) largest = right;
    if (largest != i) {
        swap(a[i], a[largest]);
        max_heapify(a, largest, heap_size);
    }
}
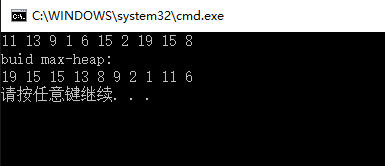
build_max_heap從最後一個非葉節點(索引 n/2 - 1)逆序向前調用 max_heapify。雖單次 O(log n),但總複雜度經證明為 O(n)(非漸近緊確的 O(n log n))。
void build_max_heap(vector<int>& a, int heap_size) {
    for (int i = heap_size / 2 - 1; i >= 0; --i)
        max_heapify(a, i, heap_size);
}
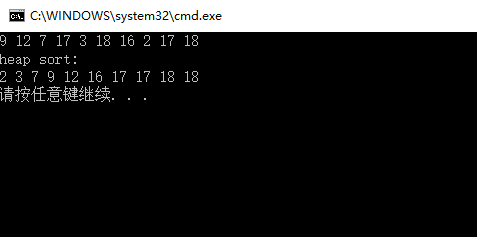
max_heapify 恢復堆性質總複雜度 O(n log n),原址、不穩定。
void heapsort(vector<int>& a) {
    int n = a.size();
    build_max_heap(a, n);
    for (int i = n - 1; i >= 1; --i) {
        swap(a[0], a[i]);
        max_heapify(a, 0, i);
    }
}
核心思想:選取基準值,通過 partition 將數組劃分為「小於基準」與「大於基準」兩區,遞歸排序兩區。
int partition(vector<int>& a, int p, int r) {
    int x = a[r];
    int i = p - 1;
    for (int j = p; j < r; ++j) {
        if (a[j] < x) {
            ++i;
            swap(a[i], a[j]);
        }
    }
    swap(a[i + 1], a[r]);
    return i + 1;
}

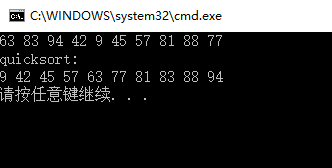
void quicksort(vector<int>& a, int p, int r) {
    if (p < r) {
        int q = partition(a, p, r);
        quicksort(a, p, q - 1);
        quicksort(a, q + 1, r);
    }
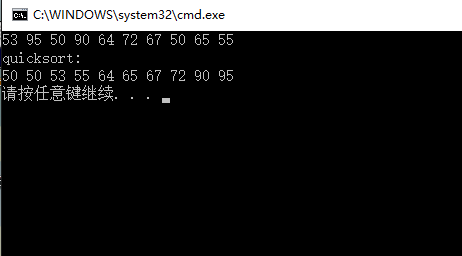
}隨機化快排:隨機選取基準,避免有序數組導致最壞情況,期望複雜度 O(n log n)。
int randomized_partition(vector<int>& a, int p, int r) {
    int i = rand() % (r - p + 1) + p;
    swap(a[i], a[r]);
    return partition(a, p, r);
}
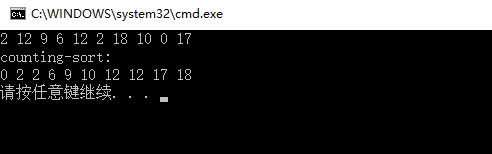
適用於 0~k 間整數。統計每個值出現次數,累積計數即得排序後位置。穩定、O(k+n)。
void counting_sort(vector<int>& A, vector<int>& B, int k) {
    vector<int> C(k + 1, 0);
    for (int x : A) ++C[x];
    for (int i = 1; i <= k; ++i) C[i] += C[i - 1];
    for (int i = A.size() - 1; i >= 0; --i) {
        B[C[A[i]] - 1] = A[i];
        --C[A[i]];
    }
}
算法實現需熟練掌握代碼編寫,並能嚴謹證明時間複雜度,這是工程師的基本功。參考經典教材《算法導論》可深化理解。