編譯原理課程實驗要求實作詞法分析器,為深入理解正規表示式 → NFA → DFA 轉換流程,自行開發一個類 Lex 的生成器。輸入詞法規則描述,輸出 C 語言詞法掃描器源碼。
三區塊結構,界符須置於行首:
%{ C代碼區塊 %}
%! 定義區塊 %!
%%
正規表示式 方法體 %$
正規表示式 方法體 %$
...
%%
%{ %})內容原樣複製至生成掃描器,可預定義輔助函數、變數。
%! %!)格式 名稱 = 函數名,定義自訂字符類別:
digit = isDigit
letter = isLetter
需在 C 代碼區實作對應判斷函數:
int isDigit(char ch) { return ch >= '0' && ch <= '9'; }
int isLetter(char ch) { return (ch>='a'&&ch<='z') || (ch>='A'&&ch<='Z'); }
規則區可用 {digit}、{letter} 參照。
%% %%)核心區塊,每行:正規表示式 方法體
({letter}|_)({letter}|_|digit)* { printf("<$ID, %s>", LEX_TEXT); }
意義:以字母或底線開頭,後接字母/數字/底線 → 識別符。LEX_TEXT 為匹配文本緩衝區。
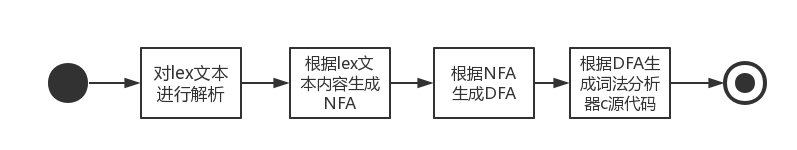
% 為轉義符)* > 連接 > |,使用棧基演算法(Thompson 構造)set 去重、queue 遍歷,ε-closure 處理switch(state) 狀態機,每個 case 對應狀態轉移與動作class Lex {
public:
Lex(string _lexFile);
Lex(string _lexFile, string _outCFile);
void init();
void scanner(); // 主入口
void work(); // 執行完整流程
private:
// 正規表示式解析
void getFunc(string str, int line);
void getRegular(string str, int line);
bool isExpre(vector>&);
void regrToNFA(vector>&, int, int, int&);
// 自動機構造
void addNFANode(int, string, int);
void addDFANode(int, string, int);
void getNFA();
void getDFA();
void findBeGo(int, string, vector*);
vector* getState(vector*, string);
void getVt(map, int>&);
// 代碼生成
void outCodeLeft(); // scanner 函數前樣板
void outCodeMid(); // switch 狀態機主體
void outCodeRight(); // scanner 函數後樣板
// 資料成員
string lexFile, outCFile;
map funcMap; // 自訂輸入→函數映射
vector>> regrVet; // 正規表示式 AST
vector funcVet; // 方法體
vector nfaVet[MAXID], dfaVet[MAXID];
set inputSet;
int nfaEnd[MAXID], dfaEnd[MAXID];
int nfaNum, dfaNum;
};
%{
#include
#include
#include
const int KEY_NUM = 32;
const char* KEY_SET[] = { "auto","break","case",... };
int isDigit(char ch) { return ch>='0'&&ch<='9'; }
int isLetter(char ch) { return (ch>='a'&&ch<='z')||(ch>='A'&&ch<='Z'); }
%}
%!
digit = isDigit
letter = isLetter
%!
%%
{digit}+          { printf("<$NUM, %s>", LEX_TEXT); } %$
{letter}({letter}|{digit})*  { ... } %$
"+"               { printf("<+>"); } %$
...
%%
#include#include #include "aaa.h" int main() { int a = 5; int b = a + 3.5E3; char s[] = "I love the world\n"; for(int i=0; i<5; i++) printf("%s\n", s); }
<#include, -> <$ID,main> <(,> <),> <{,>
<$ID,a> <=,> <$NUM,5> <;,>
<$ID,b> <=,> <$ID,a> <+,> <$NUM,3.5E3> <;,>
<$ID,s> <[>, <]>, <=,> <$STR,"I love the world\n"> <;,>
<$ID,for> <(,> <$ID,int> <$ID,i> <=,> <$NUM,0> <;,> <$ID,i> <<,> <$NUM,5> <;,> <$ID,i> <++,> <),> <$ID,printf> <(,> <$STR,"%s\n"> <,,> <$ID,s> <),> <;,> <},>
完整源碼:GitHub Repository