編譯器的詞法分析器負責將源代碼分解為一個個符號。在 C 語言中,符號之間的空白字符會被忽略。本文深入探討符號與字符間的關係,以及常見的詞法誤區。
將 == 誤寫為 = 是經典且隱蔽的錯誤。看示例:
#include <stdio.h>

int main() {
    int i = 10, j = 20;
    if (i = j) {          // 誤寫:執行賦值而非比較
        printf("i equal j\n");
    }
    return 0;
}
錯誤分析:i = j 將 j 的值(20)賦給 i,表達式值為 20(非零),if 判斷為真,導致程序邏輯錯誤。只有當 j 為 0 時,條件才為假。
驗證代碼:將 j 改為 0,程序將不輸出任何內容,證明了上述分析。
防範建議:養成「常量在左」習慣(if (20 == i)),若誤寫為 = 編譯器會直接報錯。
C 編譯器採用「貪心法」(Maximal Munch):每個符號應包含盡可能多的字符。
單字符符號:/、*、=
多字符符號:/*、==、+=
a---b 的解析
#include <stdio.h>

int main() {
    int a = 10, b = 2;
    printf("a = 10, b = 2, a---b = %d\n", a---b);
    return 0;
}
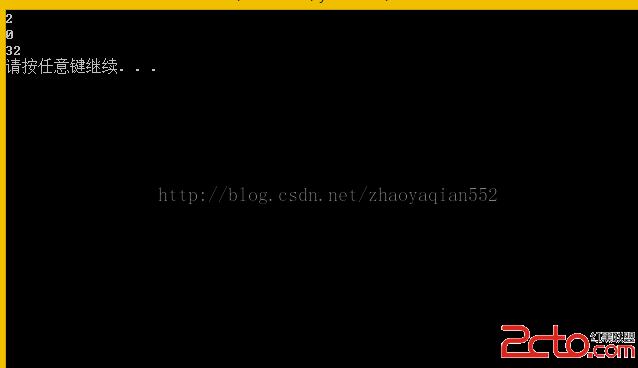
輸出結果:8
解析過程:按貪心法,a---b 分解為 a-- - b(後綴遞減 a-- 減去 b)。先取 a 的值 10 參與減法,再將 a 變為 9。故 10 - 2 = 8。
許多開發者直覺以為是 a - --b(預期結果 7),這正是貪心法導致的認知偏差。
以 0 開頭的整型常量被視為八進制數。
#include <stdio.h>

int main() {
    int a = 11, b = 011;
    printf("a = %d, b = %d\n", a, b);  // 輸出:a = 11, b = 9
    return 0;
}
011 八進制 = 1×8¹ + 1×8⁰ = 9(十進制)。這在處理權限掩碼(如 chmod 0755)時尤為常見,但若無意中在十進制數前加 0,極易引發邏輯錯誤。
| 特性 | 字符 'a' | 字符串 "a" |
|---|---|---|
| 本質 | 整數(ASCII 碼值 97) | 指針(指向以 \0 結尾的匿名數組) |
| 類型 | int (C 語言中) | char * |
| 大小 | sizeof('a') == sizeof(int) | sizeof("a") == 2 (含結束符) |
// 這兩種寫法等效
printf("Hello world\n");

char hello[] = {'H','e','l','l','o',' ','w','o','r','l','d','\n', 0};
printf(hello);
核心區別:單引號代表字符的編碼值;雙引號代表存儲字符序列的數組首地址。混淆二者可能導致編譯錯誤或難以預測的運行時行為。
if (CONST == var) 防止誤賦值。a---b 這類模糊表達式,使用括號明確意圖:(a--) - b。'x'(整數)與 "x"(指針),字符串字面量存儲在只讀區,不可修改。掌握這些詞法細節,能顯著減少難以排查的低級錯誤,提升代碼質量與可維護性。