專案背景
受 "The Linux Kernel Fuck Count" 專案啟發,作者定期掃描 Linux Kernel 原始碼 (C, H, S 檔) 中的髒話詞彙統計,觀察開發文化演變。數據每月更新,新版本釋出時同步統計。
統計結果可視化
1. 絕對數量趨勢:隨版本爆增
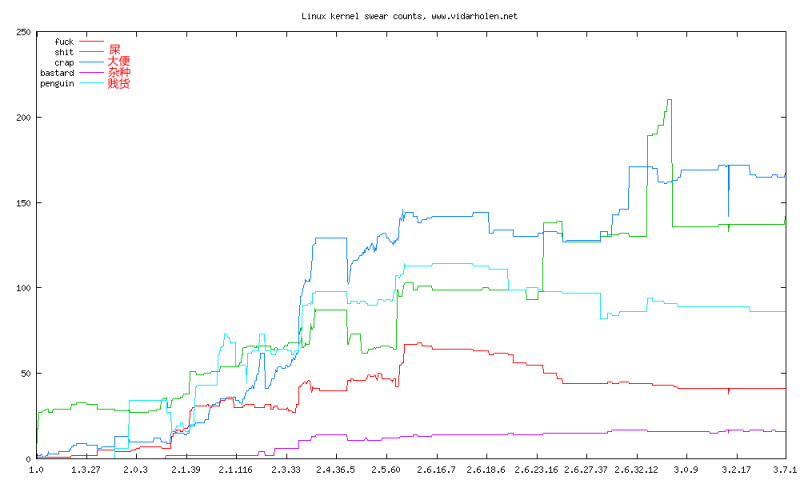
自 Linux 2.4 版本起,髒話總量呈指數級增長。這對應著核心代碼規模的劇烈擴張、開發者社群數量激增、以及驅動程式碼大量併入主線。
2. 密度趨勢:單位代碼髒話率下降
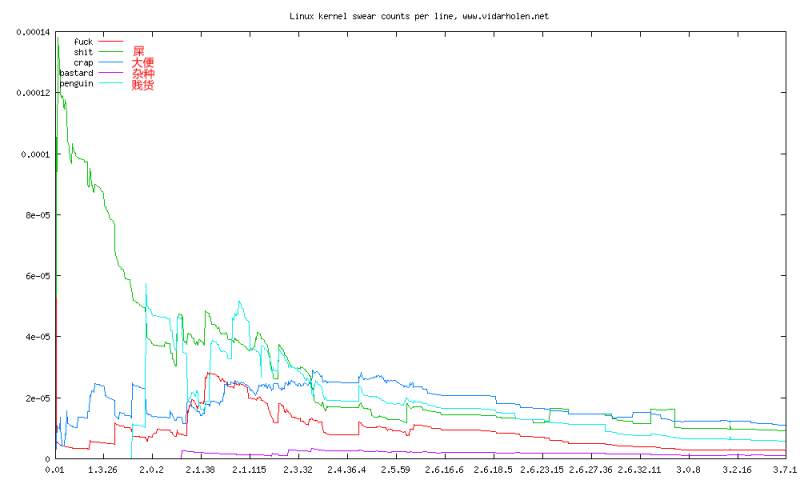
雖然絕對數量增加,但總代碼行數增長更快,導致平均每千行代碼的髒話密度呈現**下降趨勢**。這反映出專案成熟度提升、程式碼審查機制強化、企業級貢獻者比例上升 (企業員工通常遵循職業編碼規範)。
統計方法論
- 掃描範圍: 所有
.c, .h, .S 檔案。
- 匹配規則: 簡單字串匹配,包含詞中詞 (如 "fucking" 計入 "fuck")。未做詞邊界限定。
- 重複計算: 同一行出現多次,重複計入 (開發者可能極度挫折)。
- 工具限制: 最初嘗試正則表達式精確匹配,但 FreeBSD regex 引擎存在記憶體洩漏,改用簡單字串掃描。
文化與技術解讀
為什麼核心代碼會有髒話?
- 硬體/規格挫折: 驅動開發常面對文件錯誤、硬體怪癖、廠商不配合。
- 歷史包袱: 修復舊代碼、處理邊緣案例時的無力感。
- 社群文化: 早期核心圈子小、關係密切、溝通直接、情緒宣洩少顧忌。
- 註釋風格: 部分髒話出現在幽默註釋、彩蛋、或表達「這裡有坑」的警告中。
密度下降的深層原因
- 企業化貢獻: Intel, Red Hat, Google 等大廠工程師遵循內部編碼規範。
- Code Review 常態化: Gerrit/GitLab 流程中,不當言辭會被要求修改。
- Code of Conduct 採用: 2018 年 Linux 核心採用貢獻者公約,明確規範溝通禮儀。
- 自動化檢查: CI 流程可整合
checkpatch.pl 等工具攔截髒話。
相關資源與延伸閱讀
結語
髒話統計不只是趣聞,它是開源專案演變的側寫:從極客自發協作走向工業級工程建設。代碼品質與專業度的提升,正體現在這些數字的變化中。