| 術語 | 定義 | |||
|---|---|---|---|---|
| 空閒塊 | 未分配、位址連續的記憶體區域 | |||
| 佔用塊 | 已分配給使用者的位址連續記憶體區域 |
| 類型 | 適用場景 | 分配/回收複雜度 |
|---|---|---|
| 固定大小 | 所有請求大小相同 | O(1) / O(1) - 僅操作表頭 |
| 多規格 | n 種固定大小 | O(1) / O(1) - n 條獨立鏈表 |
| 變長請求 | 大小任意、動態變化 | 需掃描鏈表 - 見下文演算法 |
// 共同前提:尋找 size ≥ N 的空閒塊,分割配置 N,剩餘 (M-N) 重新插入鏈表
| 演算法 | 策略 | 鏈表排序 | 優點 | 缺點 |
|---|---|---|---|---|
| First Fit 最先適配 | 順序掃描,找第一個 ≥ N | 無序 | 分配快、回收簡單(插表頭) | 產生大量小碎片集中表頭 |
| Best Fit 最佳適配 | 找 ≥ N 且最接近 N | 遞增 | 減少碎片、空間利用率高 | 需全表掃描、回收需有序插入 |
| Worst Fit 最差適配 | 找最大空閒塊分割 | 遞減 | 保留大塊、減少無法分配風險 | 同 Best Fit、大塊易被破壞 |
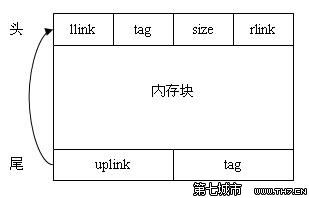
單純歸還節點會導致物理相鄰空閒塊分離,需合併相鄰塊獲取更大空間。但空閒鏈表非物理序 → 掃描合併代價高。
typedef struct Block {
    struct Block *llink, *rlink; // 雙向循環鏈表指標
    size_t size;                 // 區塊大小
    struct Block *uplink;        // 指向區塊起始位址
    int tag;                     // 0=空閒, 1=佔用 (頭尾各一)
} Block;
void free_block(Block *p) {
    // 左鄰塊:位址 = p - sizeof(tag)
    Block *left_tag = (Block*)((char*)p - sizeof(int));
    if (left_tag->tag == 0) { // 左鄰為空閒
        Block *left_block = left_tag->uplink;
        // 合併到左鄰塊
        left_block->size += p->size + 2*sizeof(int);
        left_block->uplink = left_block; // 更新
        // 從鏈表移除 p
        p->llink->rlink = p->rlink;
        p->rlink->llink = p->llink;
        p = left_block; // 更新當前塊指標
    }

    // 右鄰塊:位址 = p + size(p) - sizeof(tag) + sizeof(tag) = p + size(p)
    Block *right_tag = (Block*)((char*)p + p->size - sizeof(int));
    if (right_tag->tag == 0) { // 右鄰為空閒
        Block *right_block = right_tag->uplink;
        // 合併右鄰塊到 p
        p->size += right_block->size + 2*sizeof(int);
        // 修正鏈表
        right_block->llink->rlink = right_block->rlink;
        right_block->rlink->llink = right_block->llink;
        // 更新右塊 uplink
        right_block->uplink = p;
    }

    // 將合併後的 p 重新插入空閒鏈表
    // ...
}
維護全域指標 Block *rover 指向上次分配節點的後繼,避免每次從頭掃描,緩解 First Fit 表頭碎片化問題。
原文連結:CSDN 部落格