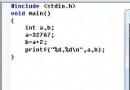
此表達式在C標準中屬於未定義行為 (Undefined Behavior, UB)。不同編譯器、不同優化等級、不同架構下結果可能完全不同。絕對不要在生產代碼中編寫此類表達式。
C99/C11 標準 (ISO/IEC 9899) 6.5 段落 2-3:
「如果對同一標量對象的副作用在兩個序列點之間發生超過一次,或者在存儲值的同時該對象被其他方式訪問,則行為未定義。」
a+++a++ 經詞法分析為 a++ + a++,在無序列點的情況下對a進行了兩次修改 (兩次後置++),且值被用於加法運算,違反上述規則。
| 編譯器 | 版本 | 架構 | a最終值 | b值 |
|---|---|---|---|---|
| GCC | 4.8.1 | 32-bit | 3 | 3 |
| Clang | 3.4 | 32-bit | 3 | 2 |
| MSVC | 2013 | 32-bit | 3 | 2 |
| Turbo C | 2.0 | 16-bit | 3 | 2 |
| GCC | 9.3 | 64-bit -O2 | 3 | 4 |
編譯器對求值順序和副作用完成時機的處理不同:
+運算元左右求值順序++的副作用(寫回內存)何時完成未規定a保持在寄存器,延遲寫回內存a+++a++ → a++ + a++ (非 a + ++a++)
// 編譯器總是嘗試匹配最長合法token
// 同理:a---b → a-- - b// 清晰、定義行為、可移植
b = a + a;
a += 2;
// 或分步
b = 2 * a;
a = a + 2;||、&&、?:、函數調用後)a = a++ + ++a 類寫法純粹有害gcc -Wall -Wextra -Wsequence-point、Clang UBSan -fsanitize=undefined若面試官問此題:
這類題目考察的是對C語言標準、編譯器實現、未定義行為的深度理解,而非"算出結果"的技巧。真正的專業素養是拒絕編寫、識別並重構此類代碼。