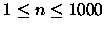ltl熱愛玩魔獸爭霸,為了不拖團隊後腿,他需要在多個地點刷怪升級。每個地點都需要購買補給和道具(花費ci),刷完可獲得經驗值vi。ltl擁有固定金額M,共有N個地點可選,且選定地點必須刷完所有怪物。目標是在預算內最大化總經驗值。
這是一個經典的0/1背包問題:
標準0/1背包動態規劃:
for(i=0; i<n; i++)
    for(j=m; j>=num[i].c; j--)
        dp[j] = max(dp[j], dp[j-num[i].c] + num[i].w);
時間複雜度O(N×M),其中M可達1,000,000,N≤100,最坏情況約10^8次操作,導致TLE。
觀察到:處理前i個物品時,實際需要考慮的容量上限是剩餘物品總花費與背包容量的較小值。具體優化:
s = 0;
for(i=0; i<n; i++) s += num[i].c; // 總花費

for(i=0; i<=m; i++) dp[i] = 0;

for(i=0; i<n; i++) {
    s -= num[i].c;
    int lower = max(m - s, num[i].c); // 動態下界
    for(j=m; j>=lower; j--)
        dp[j] = max(dp[j], dp[j-num[i].c] + num[i].w);
}當剩餘物品花費較小或當前物品花費較大時,大幅減少無效循環次數。實測通過NYOJ 654測試數據,時間從TLE優化至AC。
本題展示了0/1背包在大容量情況下的實用優化技巧:利用問題特性動態縮小DP狀態轉移範圍,避免不必要的計算。這是競賽編程中常見的「常數優化」思想,配合正確的狀態定義,往往能解決看似超時的問題。