Ignatius 面臨一個統計難題:老師給了許多單詞(僅包含小寫字母,無重複),要求統計以某個字符串為前綴的單詞數量(單詞本身也算作自己的前綴)。
輸入分兩部分:第一部分是單詞表,每行一個單詞(長度 ≤ 10),空行結束;第二部分是查詢字符串,每行一個,處理到文件結束。對每個查詢,輸出以該字符串為前綴的單詞數量。
字典樹(Trie),又稱單詞查找樹,是一種樹形結構,專門用於高效存儲和查詢字符串集合。其核心優勢在於利用字符串的公共前綴減少查詢時間,最大限度減少無謂的字符串比較,查詢效率優於哈希表。這是典型的以空間換時間的策略:每個節點包含 26 個子節點指針(對應 26 個小寫字母),雖然空間複雜度較高,但能實現 O(L) 的查詢複雜度(L 為字符串長度)。
以僅含 a、b、c、d 四個字母為例,字典樹的構建過程如下圖所示:
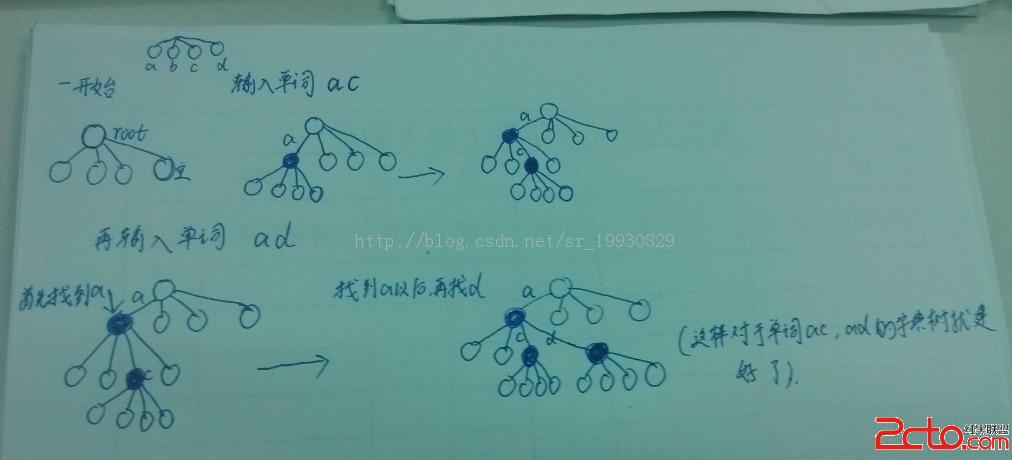
每個節點維護一個計數器 cnt,表示經過該節點的單詞數量。插入單詞時,從根節點開始,按字符遍歷:若子節點不存在則創建並初始化 cnt=1,否則將對應子節點的 cnt 加 1。
查詢時同樣從根節點按字符向下遍歷:若中途遇到空指針,說明無該前綴,返回 0;遍歷完所有字符後,當前節點的 cnt 即為以該字符串為前綴的單詞數量。
#include <iostream>
#include <cstring>
#include <cstdio>
#include <cstdlib>
using namespace std;

char str[12];
const int MAXN = 26;

struct Trie {
    int cnt;
    Trie *next[MAXN];
};

Trie root;

void CreateTrie(char *str) {
    int len = strlen(str);
    Trie *p = &root, *q;
    for (int i = 0; i < len; i++) {
        int id = str[i] - 'a';
        if (p->next[id] == NULL) {
            q = (Trie*)malloc(sizeof(Trie));
            q->cnt = 1;
            for (int j = 0; j < MAXN; j++) q->next[j] = NULL;
            p->next[id] = q;
            p = p->next[id];
        } else {
            p->next[id]->cnt++;
            p = p->next[id];
        }
    }
}

int find(char *str) {
    int len = strlen(str);
    Trie *p = &root;
    for (int i = 0; i < len; i++) {
        int id = str[i] - 'a';
        p = p->next[id];
        if (p == NULL) return 0;
    }
    return p->cnt;
}

int main() {
    while (gets(str) && str[0] != '\0') {
        CreateTrie(str);
    }
    while (scanf("%s", str) != EOF) {
        printf("%d\n", find(str));
    }
    return 0;
}
q->cnt = 1 而非 q->cnt++,避免未初始化內存導致錯誤p = p->next[id]; if(p==NULL)),否則會漏檢最後一個字符gets 讀取單詞表,scanf 讀取查詢,配合 EOF 判斷結束本題是字典樹的經典入門應用,掌握其構建與查詢邏輯,對解決字符串前綴統計、自動補全、IP 路由匹配等問題極有幫助。