假設有一張銷售記錄表 sales,結構如下(主鍵 id、地區 region、銷售人員 sales、銷售金額 total):
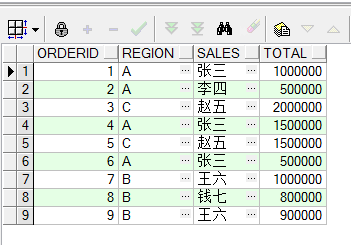
需求:查詢出所有「銷售金額超過該地區平均銷售金額」的記錄。
這是一個典型的「分組統計後關聯原表篩選」問題。核心步驟:
region 分組,計算各地區的平均銷售額 AVG(total)。JOIN,依地區關聯。WHERE 條件中比較原表 total 與統計表的平均值。SELECT s.*
FROM sales s
JOIN (
SELECT region, AVG(total) AS avg_total
FROM sales
GROUP BY region
) avg_t ON s.region = avg_t.region
WHERE s.total > avg_t.avg_total;SELECT 表名.*
FROM 表名,
(SELECT AVG(total) t, region FROM 表名 GROUP BY region) ta
WHERE 表名.region = ta.region
AND 表名.total > ta.t;雖然語法較舊(使用逗號隱式連接),但邏輯完全正確:子查詢 ta 計算各區域平均值 t,主查詢關聯後篩選 total > t。
JOIN ... ON 語法,可讀性更強,避免笛卡兒積風險。region 欄位有索引,子查詢結果集較小,通常性能良好。SELECT *
FROM (
SELECT *, AVG(total) OVER (PARTITION BY region) AS avg_total
FROM sales
) t
WHERE total > avg_total;掌握「子查詢分組統計 + 關聯篩選」模式,可輕鬆解決各類「超過群體平均/最大/最小值」的業務查詢需求。