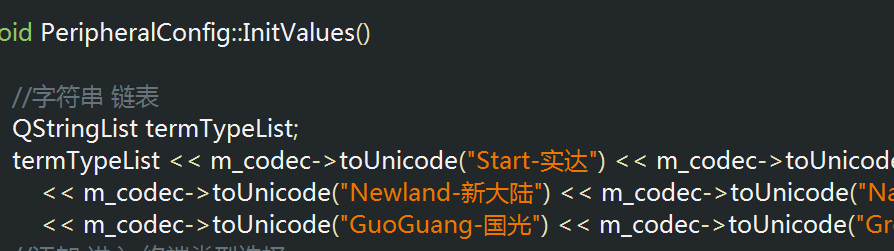
從文本文件讀取包含中文的詞典數據,printf("%s", chinese) 輸出亂碼(如 ??越橫穿?)。
char 單字節,%s/%c 僅處理 ASCII (32-127)。中文編碼(雙字節/多字節)超出此範圍,標準庫無法正確解析邊界。if (ch < 0) 判斷中文依賴 char 有符號特性,不可移植;未處理多字節字符的完整性(如 GBK 兩字節需成對讀取)。chcp 65001,或用 Windows Terminal)。wchar_t、wprintf、fgetwc 等寬字符函數,或引入 iconv/ICU 庫轉碼。SetConsoleOutputCP(CP_UTF8); // 需 #include
SetConsoleCP(CP_UTF8);
// 讀取時以二進制模式打開,手動解碼
FILE *fp = fopen("text.txt", "rb");
// 讀取原始字節,按已知編碼(如GBK)解碼為寬字符再輸出
feof 控制循環,改用 while ((ch = fgetc(fp)) != EOF)。isleadbyte(ch) (Windows) 或檢查 UTF-8 首字節標記位。wprintf(L"%ls", wstr) 配合寬字符串。C 語言標準庫不原生支持多字節字符,**編碼統一 + 寬字符 API + 終端配置** 是解決中文亂碼的正規路徑。教學階段可先用英文數據驗證邏輯,再引入編碼處理。