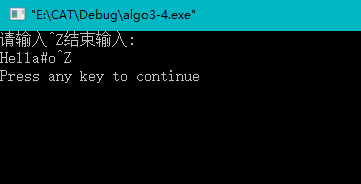
在 C# 進行檔案讀取操作時,初學者常會遇到一個經典的邏輯錯誤:同樣使用 StreamReader.ReadLine() 方法,為什麼兩種寫法的執行結果截然不同?這篇文章將深入剖析這個看似簡單實則隱藏陷阱的問題。
static void ReadFile() {
    FileStream file = new FileStream(@"C:\Users\Administrator\Desktop\io.txt", FileMode.Open);
    StreamReader sr = new StreamReader(file);
    while (sr.ReadLine() != null) {
        Console.WriteLine(sr.ReadLine());
    }
}
static void ReadFile() {
    FileStream file = new FileStream(@"C:\Users\Administrator\Desktop\io.txt", FileMode.Open);
    StreamReader sr = new StreamReader(file);
    string line;
    while ((line = sr.ReadLine()) != null) {
        Console.WriteLine(line);
    }
}
關鍵在於每次循環中調用 ReadLine() 的次數:
while 條件判斷時調用一次,在 Console.WriteLine 輸出時又調用一次。每次循環實際讀取了兩行數據,但只輸出了第二行,導致奇數行數據被跳過且未顯示。line,條件判斷和輸出都使用同一個變數。每次循環只讀取一次,確保每一行都被正確處理。ReadLine() 的返回值賦值給變數後再進行判斷和使用using 語句確保資源正確釋放File.ReadLines() 或 File.ReadAllLines() 簡化代碼// 現代寫法推薦
using (var sr = new StreamReader(@"C:\path\to\file.txt")) {
string line;
while ((line = sr.ReadLine()) != null) {
Console.WriteLine(line);
}
}
// 或更簡潔
foreach (var line in File.ReadLines(@"C:\path\to\file.txt")) {
Console.WriteLine(line);
}
這個問題的本質是對流讀取機制理解不夠透徹。StreamReader 內部維護著讀取位置指針,每次調用 ReadLine() 都會向前移動一行。在條件判斷和業務邏輯中重複調用,會導致數據漏讀。養成「先賦值,再判斷,後使用」的習慣,能有效避免此類低級錯誤。